O jazyce Python
Python can do just about anything, just not very well. – Michael Reeves
Python je populární a univerzální programovací jazyk, který je oblíbený pro svou jednoduchost a čitelnost. Níže jsou uvedeny základní rysy jazyka Python:
- Jednoduchá a čitelná syntaxe: Python má jednoduchou a přehlednou syntaxi, která je blízká přirozenému jazyku a pseudokódu, což usnadňuje učení a práci s kódem. Díky odsazování je struktura kódu jasně viditelná.
- Interpretovaný jazyk: Python je interpretovaný jazyk, což znamená, že kód je prováděn přímo bez nutnosti kompilace. To umožňuje rychlejší vývoj a ladění.
- Dynamické typování: Python je dynamicky typovaný jazyk, což znamená, že proměnné nemusí být explicitně deklarovány s typem. Typ proměnné je určen během běhu programu.
- Automatická správa paměti: Python automaticky spravuje přidělování a uvolňování paměti pomocí garbage collectoru (GC). To znamená, že vývojář se nemusí starat o ruční uvolňování paměti, jako je tomu v některých jiných jazycích (např. C nebo C++).
- Podpora více paradigmat: Python je multiparadigmový jazyk, podporuje objektově orientované, procedurální i funkcionální programování.
- Portabilita: Python je multiplatformní jazyk, což znamená, že kód napsaný v Pythonu může běžet na různých operačních systémech, jako jsou Windows, macOS a Linux, bez nutnosti úprav.
- Velká standardní knihovna: Python má rozsáhlou standardní knihovnu, která poskytuje širokou škálu funkcí a modulů, jež usnadňují provádění různých úkolů, jako je práce se soubory, komunikace po síti, zpracování textu a mnoho dalších.
- Bohatá komunita a ekosystém: Python má rozsáhlou a aktivní komunitu, která neustále vyvíjí nové knihovny, nástroje a frameworky. To zajišťuje, že Python zůstává aktuální a relevantní pro moderní vývojářské potřeby.
- Jednoduchá integrace s jinými jazyky: Python může být snadno integrován s kódem napsaným v jiných jazycích, jako jsou C, C++ nebo Java, což umožňuje jeho využití v širokém spektru aplikací.
První program v jazyce Python
Náš první program (spíše skript) pojmenovaný hello_world.py obsahuje následující řádek:
print("ahoj světe")
Spuštění zdrojového kódu
Spustit jej můžeme jednoduše příkazem:
$ python3 hello_world.py
ahoj světe
Během provádění námi vytvořeného skriptu proběhly kroky, které byly na první pohled zatajeny.
Překlad do byte code a jeho interpretace
Prvním krokem je kompilace zdrojového kódu do formátu takzvaného byte kódu. Byte kód je uložen v souborech s příponou .pyc (compiled .py - .py je běžná přípona zdrojového kódu jazyka Python). Tyto soubory jsou od verze 3.2 uloženy ve složce __pycache__ (.pyc soubor je generován pouze pokud je daný skript importován, tento fakt však zatím ignorujme).
Pokud bude stejný program (jeho obsah nebyl změněn) spuštěn znovu, překlad do byte kódu bude přeskočen.
Přeložený program ve formě byte kódu je dále předán k vykonání Python Virtual Machine (PVM). Jedná se o program, který umí přeložený byte kód vykonat.
V tomto kurzu budeme používat (pro překlad do bytecode i jeho následné vykonání) CPython, což je standardní implementace jazyka Python vytvořená v jazyce ANSI C. CPython tak lze považovat za překladač i interpret v jednom.
Ostatní implementace jazyka Python
Proces, který jsme popsali, je standardní postup při spuštění zdrojového kódu jazyka Python, existují však další varianty a modifikace.
PyPy (pypy.org)
Alternativní implementace nahrazující CPython. Hlavní důraz je kladen na rychlost. V průměru se jedná o 4.2x rychlejší implementaci.
Jython (jython.org)
Java implementace jazyka Python. Cíleno na kombinaci jazyka Python a Java.
IronPython (ironpython.net)
.NET implementace jazyka Python a podpora jeho integrace do .NET ekosystému.
Optimalizační nástroje a rozšíření jazyka Python
Implementace jazyka Python zmíněné výše pracují stejným způsobem: přeloží zdrojový kód do byte kódu a ten spustí pomocí virtuálního stroje. Existují však hybridní implementace, jako je například Cython, které se snaží optimalizovat tento základní model vyhodnocování.
Cython
Hybridní jazyk, který kombinuje Python s C funkcemi. Cython může být přeložen na zdrojový kód jazyka C, který využívá Python/C API. Ten pak může být zkompilován jako celek. Hlavním cílem je zvýšení rychlosti.
Interaktivní práce s jazykem Python
Již jsme si ukázali, jak spustit soubor obsahující zdrojový kód v jazyce Python. Pro účely experimentování je vhodné znát a používat příkazovou řádku jazyka Python, která funguje na principu REPL (Read-Eval-Print Loop). Tu lze jednoduše spustit pomocí příkazu python3.
$ python3
Python 3.9.4 (default, Apr  5 2021, 01:50:46)
[Clang 12.0.0 (clang-1200.0.32.29)] on darwin
Type "help", "copyright", "credits" or "license" for more information.

>>>
Do interaktivního interpretu můžeme psát zdrojový kód, ten se vždy vyhodnotí a vrátí výsledek.
>>> print("ahoj světe")
ahoj světe

>>>
Vylepšená verze ipython je dostupná na https://ipython.org/install.html.
$ ipython
Python 3.9.4 (default, Apr  5 2021, 01:50:46)
Type 'copyright', 'credits' or 'license' for more information
IPython 7.25.0 -- An enhanced Interactive Python. Type '?' for help.

In [1]:
Další možností je Jupyter Notebook, což je interaktivní webová aplikace (lze ji integrovat i do VS code), která kombinuje interaktivní práci s kódem, psaním poznámek a prezentaci dat. Více najdete na https://jupyter.org/.
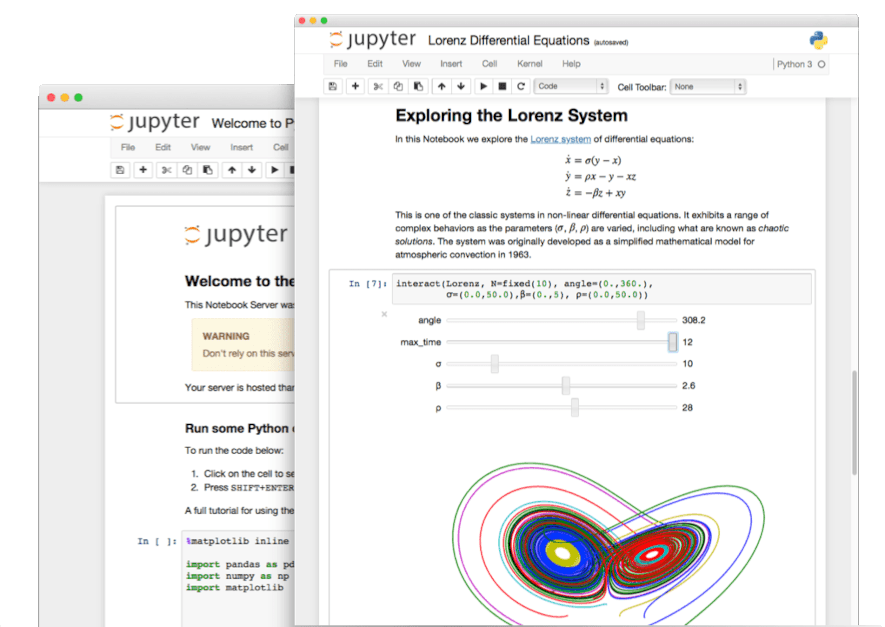
Jupyter Notebook v prohlížeči přes MetaCentrum
Jupyter Notebook není nutné instalovat na vlastní počítač. Jako studenti české vysoké školy máte zdarma k dispozici výpočetní infrastrukturu MetaCentrum, kde si Jupyter spustíte přímo v prohlížeči - stačí se přihlásit a vybrat, kolik zdrojů (jádra, paměť, případně GPU) chcete použít.
Zřízení účtu
Účet je potřeba si nejprve vytvořit, členství je pro studenty a zaměstnance českých akademických institucí bezplatné. Žádost se podává přes registrační formulář, kde si v seznamu vyberete svou školu a přihlásíte se svým školním účtem (federace eduID.cz) - vlastní jméno a heslo si tedy nevymýšlíte. Pro přihlašování do samotných služeb si následně v profilu e-INFRA CZ nastavíte heslo. Vyřízení žádosti obvykle zabere nějaký čas (zpravidla do 2 dnů), proto s registrací neotálejte.
Účet se vyplatí zřídit i mimo tento předmět - kromě Jupyteru dává přístup k výpočetním klastrům pro dlouhé výpočty, ke GPU pro strojové učení, k datovým úložištím, ke cloudu s virtuálními stroji nebo k licencovanému softwaru (například MATLAB). Hodí se tedy na bakalářskou či diplomovou práci i na jakékoli počítání, které se na notebook už nevejde.
Dvě možnosti, jak Jupyter spustit
-
JupyterHub nad Kubernetes (doporučuji) - hub.cloud.e-infra.cz
Po přihlášení si vyberete připravený obraz (kromě Pythonu existují i obrazy s RStudiem, MATLABem nebo VS Code) a množství zdrojů. Vznikne vám tím virtuální stroj, který lze libovolně zastavovat a znovu spouštět, přičemž vaše soubory v pracovní složce zůstávají zachovány. Můžete tak v jedné složce pracovat klidně celý semestr. Pokud notebook necháte nečinný, prostředí se samo uspí, aby zbytečně neblokovalo zdroje.
Tuto variantu doporučuji jako výchozí volbu pro práci v tomto předmětu.
-
OnDemand - ondemand.metacentrum.cz
Zde se Jupyter spustí jako běžná úloha plánovače PBS, tedy stejným způsobem, jakým se na MetaCentru počítají velké výpočty. Kromě množství zdrojů proto zadáváte i časový limit běhu (walltime). Po jeho vypršení jsou zdroje uvolněny a pracovní prostředí úlohy včetně dat v něm zaniká, výsledky je tedy nutné si průběžně ukládat do domovského adresáře nebo stáhnout k sobě. Limit lze v případě potřeby ještě prodloužit.
Varianta je vhodná na krátké testování nebo na práci v rámci jedné hodiny - po skončení se vše samo uklidí.
Podrobný popis obou možností najdete v dokumentaci MetaCentra.
Konvence PEP8
PEP 8 (Python Enhancement Proposal 8) je oficiální dokument, který definuje konvence pro psaní kódu v jazyce Python. Cílem PEP 8 je poskytnout doporučení a pravidla, která vedou k čistému, konzistentnímu a čitelnému kódu. Dodržování těchto konvencí usnadňuje spolupráci mezi vývojáři a zlepšuje udržovatelnost kódu. Více najdete zde.
Automatické formátování kódu
Autopep8 je nástroj pro automatickou úpravu kódu v jazyce Python tak, aby odpovídal konvencím a pravidlům definovaným v PEP8. Tento nástroj analyzuje zdrojový kód a automaticky provede některé potřebné změny (například Vám ale nezmění pojmenování proměnných). Pomocí rozšíření jej lze plně integrovat do Visual Studio Code.
Black je další nástroj pro automatickou úpravu kódu. Zůstává v souladu s PEP8, ale navíc pevně rozhoduje i to, co PEP8 nechává na programátorovi (například délku řádku 88 znaků nebo dvojité uvozovky). Black je navržen tak, aby poskytoval "one true way" formátování, což znamená, že vždy dává stejný výstup pro stejný vstup bez ohledu na kontext nebo konfiguraci. Výsledkem je konzistentní vzhled kódu napříč projektem.
Základy jazyka Python
Základní datové typy
42
3.14
complex(-1, 0)

"ahoj svete"
'ahoj svete'
'ahoj "svete"'

"""Ahoj svete,
toto je delsi text,
ma nekolik radku.
"""

True
False
None
# PEP8 - je možné používat jak uvozovky tak apostrofy, konzistence je však klíčová
"ahoj svete"
'ahoj svete'
Číselné operátory
Více informací zde.
7 + 4
-7 + 4
-(7 + 4)
7 / 4
7 // 4
7 % 4
2 ** 3
abs(-42)
# PEP8 - mezery okolo operátorů
# správně
7 + 4
# špatně
7+4
# PEP8 - mezery okolo závorek
# správně
(7 + 4)
# špatně
( 7 + 4 )
Pravdivostní operátory
Více informací zde.
True and False
True or False
not True and False
not (True and False)
Porovnání
Více informací zde.
5 == 5
5 < 2
5 <= 5
5 >= 5
5 > 3
5 != 2
Operace se sekvencemi (řetězci)
Více informací zde.
# získání prvního prvku (znaku)
"ahoj svete"[0]
# ověření zda sekvence obsahuje prvek
"a" in "ahoj svete"
"ahoj" in "ahoj svete"
"x" not in "ahoj svete"

# spojování sekvencí
"ahoj" + " " + "svete"
"🦄 " * 5

# délka sekvence
len("ahoj svete")

# slicing
"ahoj svete"[1:3]
"ahoj svete"[0:2]
"ahoj svete"[:2]
# PEP8 - mezery a slicing
# správně
"ahoj svete"[0:2]
# špatně
"ahoj svete"[0 : 2]
Užitečné metody pro práci s řetězci
Více informací zde.
# zjištění indexu prvku v řetězci
"ahoj svete".index("e")

# počet výskytů prvku v řetězci
"ahoj svete".count("ahoj")

# nový řetězec psaný malými písmeny
"Ahoj Svete".lower()

# nový řetězec psaný velkými písmeny
"Ahoj Svete".upper()

# nový řetězec psaný jako titulek
"ahoj svete jak se mas?".title()

# nový řetězec s prohozenou velikostí písmen
"Ahoj Svete".swapcase()

# nový řetězec s velkým prvním písmenem
"každá věta začíná velkým písmenem!".capitalize()

# nový řetězec s odstraněním mezer na začátku a konci
"     ahoj svete    ".strip()

# nový řetězec s odstraněním vykřičníků na začátku a konci
"!!!!!!!!ahoj svete!!!!!!!".strip("!")

# nový řetězec s odstraněním vykřičníků na začátku
"!!!!!!!!ahoj svete!!!!!!!".lstrip("!")

# nový řetězec s odstraněním vykřičníků na konci
"!!!!!!!!ahoj svete!!!!!!!".rstrip("!")

# nový řetězec s odstraněním jednoho vykřičníku na začátku
"!!!!!!!!ahoj svete!!!!!!!".removeprefix("!")

# nový řetězec s odstraněním jednoho vykřičníků na konci
"!!!!!!!!ahoj svete!!!!!!!".removesuffix("!")

# pozor na toto neočekávané chování
"ajohsvete".lstrip("ahoj") # "svete"
"ajohsvete".removeprefix("ahoj") # "ajohsvete"

# nový řetězec ve kterém byl nahrazen podřetězec
.replace(, )


.isdecimal()
Formátování řetězců
Více informací zde. Případně dobrý článek na RealPython.
Funkce .format()
surname = "Novák"
"Lukáš {}".format(surname)
"{firstname} {surname}".format(firstname="Lukáš", surname="Novák")

# hexa
"{:x}".format(10)
"{:e}".format(10000000)

# thousands separator
"{:,}".format(1000000)

# pozor, .2 znamená 2 platné číslice (výsledek "1.2"), nikoli 2 desetinná místa
"{:.2}".format(1.2312414)
# pro 2 desetinná místa je nutné doplnit typ f (výsledek "1.23")
"{:.2f}".format(1.2312414)
f string (Python 3.6+)
Více informací zde.
surname = "Novák"
f"Lukáš {surname}"

f"calculation: {10 + 2 * 20}"

# hexa
f"{10:x}"
f"{10000000:e}"

# thousands separator
f"{1000000:,}"

# stejně jako u .format() platí, že .2 jsou 2 platné číslice
f"{1.2312414:.2}"
# a .2f jsou 2 desetinná místa
f"{1.2312414:.2f}"
debug string (Python 3.8+)
surname = "Novák"
f"{surname =}"
Transformace datových typů
bool(10)
bool(None)
str(10)
str(None)
int(7 / 4)
float(10)
int("123")
float("1.24")
int(float(1))

# nelze
int("ahoj svete")
# PEP8 - mezery
# správně
bool(10)
# špatně
bool (10)
Přiřazení
x = 10
y = 20

x, y = 10, 20

# prohození bez tmp
x, y = y, x

x += 200
x -= 10
x /= 2
x //= 2

# výsledkem je float, tedy binární přibližná hodnota, nikoli přesný zlomek
x /= 3
# pro přesný zlomek je nutné použít fractions.Fraction
# pro desítkovou přesnost (například u peněz) potom decimal.Decimal
0.1 + 0.2  # 0.30000000000000004

# řetězce jsou nemutovatelné
label = "Point 1"

# nelze - TypeError
label[-1] = "2"
# PEP8 - mezery
# správně
x = 10
y = 20
# špatně
x=10
y    = 10

# PEP8 - pojmenování proměnných
# správně (pojmenování souřadnic bodu)
x = 10
y = 20
# špatně
a = 10
g = 20

# PEP8 - pojmenování víceslovných proměnných
# správně
odd_number
# špatně
oddNumber

# PEP8 - pojmenování konstant
CENTER_X, CENTER_Y = 0, 0
Standardní výstup
print("Ahoj svete")
Větvení programu
Více informací zde.
# získání vstupu od uživatele a jeho převedení na integer
user_integer = int(input("Please enter an integer: "))

division_remainder = user_integer % 2

# příkaz větvení if pro větvení programu, pozor na dělení kódu do bloků pomocí mezer/tabulatoru, časté chyby
if not division_remainder:
    print(user_integer, "is divisible by 2")
user_integer = int(input("Please enter an integer: "))

# čitelnost - pořadí podmínek (dle četnosti výskytu), není součástí PEP8
# správně
if user_integer > 0:
    print(user_integer, "is larger than 0")
elif user_integer < 0:
    print(user_integer, "is smaller than 0")
else:
    print(user_integer, "is 0")

# špatně
if user_integer == 0:
    print(user_integer, "is 0")
elif user_integer < 0:
    print(user_integer, "is smaller than 0")
else:
    print(user_integer, "is larger than 0")
# PEP8 - Neporovnávat boolean hodnoty s True nebo False pomocí ==
boolean_value = False

# správně
if boolean_value:
    print("It is true!")

# špatně
if boolean_value == True:
    print("It is true!")
# čitelnost - u testu na nulu si vystačíme s pravdivostní hodnotou čísla,
# není součástí PEP8 (PEP8 řeší pouze porovnávání s True/False výše)
number_value = 42

# kratší a běžný zápis
if number_value:
    print("Not equal to zero!")

# zbytečně explicitní - nepoužívat
if number_value != 0:
    print("Not equal to zero!")
Pozor, tato zkratka má své hranice. Pokud proměnná může obsahovat i None nebo prázdnou
sekvenci, if number_value nerozliší hodnotu 0 od „hodnota nebyla zadána". V takové
situaci je explicitní if number_value != 0 (případně if number_value is not None)
naopak správnou volbou.
V Pythonu máme také k dispozici ternární operátor, ale s odlišnou syntaxí oproti jazyku C.
# ternární operátor ve tvaru: a if condition else b
number_parity = "even" if (number_value % 2 == 0) else "odd"
Kolekce
Kolekce v Pythonu lze rozdělit podle dvou kritérií. Tím prvním z nich je rozdělení na:
- Kontejnerové kolekce: mohou obsahovat hodnoty různých typů, například i další vnořené kontejnerové kolekce. Mezi tyto kolekce patří
list,tuple,dictneboset. - Ploché kolekce: obsahují hodnoty jednoho z primitivních typů. Mezi tyto kolekce patří
str,bytes(nebudeme nějak blíže rozebírat) neboarray.array.
Druhé kritérium je dle mutovatelnosti:
- Mutovatelné kolekce: jednotlivé hodnoty kolekce lze libovolně měnit. Mezi tyto kolekce patří
list,set,dictneboarray.array. - Nemutovatelné kolekce: kde vytvořenou kolekci již nelze měnit. Mezi tyto kolekce patří
str,tuplenebofrozenset.
List (seznam)
Více informací zde nebo zde. Pokud chcete vědět, jak je seznam implementovaný, doporučuji tento článek.
numbers = [10, 20, 5, 10]
point = ["Point 1", 10, 20]
zeros = [0] * 10
# PEP8 - čárka za posledním prvkem (trailing comma)
# u jednořádkového zápisu je nadbytečná
numbers = [10, 20, 5, 10]
# špatně - čárka na konci jednoho řádku
numbers = [10, 20, 5, 10,]

# u víceřádkového zápisu je naopak doporučená (přidání prvku pak mění jediný řádek)
numbers = [
    10,
    20,
    5,
    10,
]

# a u jednoprvkového tuple je čárka povinná, jinak nejde o tuple
one_number = (10,)
not_a_tuple = (10)
Pozor, formátovač Black čárku na konci chápe jako pokyn („magic trailing comma") a literál s ní rozepíše na jednotlivé řádky. Pokud tedy chcete zápis udržet na jednom řádku, čárku za poslední prvek nepište.
Práce s prvky seznamu.
# délka seznamu
len(numbers)
# počet výskytu čísla 10
numbers.count(10)

# přístup na index
numbers[0]
numbers[1]
numbers[-1]

# slicing
numbers[0:3]
numbers[-2:]
# každý prvek na sudém indexu, tj. 0, 2, 4... => [10, 5]
numbers[::2]

# chyba - IndexError
numbers[1000]

# zjištění indexu čísla 20 => 1
numbers.index(20)
Modifikace seznamu.
# modifikace prvku na indexu
numbers[0] += 20

# přidání prvku
numbers.append(99)

# odebrání prvku
numbers.remove(10)

# prodloužení seznamu
numbers.extend([1, 2, 3])

# vložení prvku 6 na pozici 0
numbers.insert(0, 6)

# smazání prvku na indexu
del numbers[0]

# následující kód se chová jako remove
# pozor, hodnota 10 už byla odebrána výše, proto seznam nejprve obnovíme
numbers = [10, 20, 5, 10]
del numbers[numbers.index(10)]

numbers = [10, 20, 5]
# odebrání posledního prvku a jeho vrácení
numbers.pop()
# odebrání prvku na indexu 1 a jeho vrácení
numbers.pop(1)
Užitečné funkce (nejen) pro seznamy.
# maximální prvek
max(numbers)
# minimální prvek
min(numbers)
# vytvoření seřazeného seznamu
sorted(numbers)
# součet prvků seznamu
sum(numbers)

# vytvoření seznamu z řetězce, proč funguje se dozvíme později
list("123456")
# chyba - int is not an iterable
list(123456)
Odbočka k řetězcům.
# seznam slov (oddělených mezerou)
"ahoj svete jak se mas".split()
# seznam slov (oddělených čárkou)
"jakub,milan,petr,tomas".split(',')
# vytvoření řetězce ze seznamu řetězců
" ".join(["ahoj", "svete", "jak", "se", "mas"])
# co je výsledek?
" ".join("ahoj")
Tuple
Více informací zde.
point = (10, 20)
point = 10, 20

len(point)

# nelze! tuple není mutovatelný
point[0] = 20

# tuple unpacking
x, y = point
Dictionary (slovník)
Více informací zde.
point = {"x": 10, "y": 20}
point = dict([("x", 10), ("y", 20)])
# PEP8 - mezery
# správně
point["z"] = 40
# špatně
point ["z"] = 40
# test zda ma slovník klíč "z"
"z" in point

# odstranění položky s klíčem "z"
del point["z"]
Přístup k hodnotě přes klíč.
# chyba - KeyError
point["z"]

# None
point.get("z")
Vnořené slovníky a jiné.
# seřazení seznam klíčů
sorted(point)
# délka slovníku (přesně řečeno klíčů)
len(point)

# zanořování slovníků
points = {"point 2": {"x": 10, "y": 20}, "point 1": {"x": 5, "y": 2}}

# přístup k vnořenému slovníku
points["point 1"]["x"]
points["point 1"]["y"]
Set (množina)
Více informací zde.
numbers = {10, 20, 5, 10}

# vytvoření množiny ze seznamu
numbers = [10, 20, 5, 10]
numbers = set(numbers)
# počet prvků v množině
len(numbers)

# testování zda má nebo nemá množina prvek
10 in numbers
100 not in numbers
Modifikace prvků.
# chyba - AttributeError, Set nemá metodu append
numbers.append(10)

# přidání prvku probíhá skrze add
numbers.add(20)
# opakované přidání nemá efekt
numbers.add(20)

# odebrání prvku
numbers.remove(20)
# chyba - KeyError, prvek v množině již není
numbers.remove(20)

# discard funguje stejně jako remove, ale chybějící prvek chybu nevyvolá
numbers.discard(20)
Vytvoření prázdné množiny.
# pozor, vytvoří slovník!
empty = {}
type(empty)

# toto je správný způsob
empty = set()
type(empty)
Používání set().
# množina písmen z řetězce
letters = set("ahoj svete")

# nelze! seznam je mutovatelný, tedy není hashovatelný, proto nemůže být prvkem množiny
lists = set([[1, 2], [3, 4], [1, 2]])

# tuple již může
tuples = set([(1, 2), (3, 4), (1, 2)])

# nelze! slovník jako celek je mutovatelný
dicts = set([{"a": 1, "b": 2}])

# pozor zde pracujeme pouze s klíči slovníku, ty hashovatelné být musí
keys = set({"a": 1, "b": 2})

# řetězce nejsou mutovatelné, proto jsou hashovatelné a proto mohou být v množině
strings = set(["ahoj", "svete"])
Používání frozenset().
# nelze, protože množina je mutovatelná
set([set([1, 2]), set([3, 4])])

# lze, protože frozenset není mutovatelný
set([frozenset([1, 2]), frozenset([3, 4])])

# nelze - frozenset není mutovatelný
frozenset([1, 2]).add(5)
array.array (pole)
Jazyk Python v základu nepodporuje datovou strukturu pole, a proto je nutné jej importovat (o tom si povíme více příště) ze standardní knihovny. Oproti seznamu může obsahovat jen číselné nebo znakové hodnoty pevně dané velikosti. Více informací zde.
from array import array

# při vytváření pole musíme předat typ hodnoty, např. 'i' odpovídá hodnotám signed int
# (dokumentace zaručuje minimálně 2 byty, na běžných platformách jsou to 4 byty,
#  vždy dvoubajtový je typ 'h')
numbers = array('i', [1, 2, 3, 4, 5])
# skutečnou velikost jedné hodnoty v bytech zjistíme z atributu itemsize
numbers.itemsize
# pole doublů o velikosti 8 bytů
doubles = array('d', [1.0, 2.0, 3.0, 4.0, 5.0])

# Přidání prvku do pole
numbers.append(6)

# Vložení prvku 6 na pozici 0
numbers.insert(0, 6)

# Vytištění všech prvků pole
print("Obsah pole:", numbers)

# Přístup k jednotlivým prvkům
numbers[0]

# Změna hodnoty prvku
numbers[1] = 10

# Odstranění prvního výskytu prvku
numbers.remove(10)

# Získání délky pole
len(numbers)

# Převod pole na seznam
numbers_list = numbers.tolist()
Cykly
Cyklus for (průchod sekvencí)
Více informací zde.
for char in "ahoj svete":
    print(char)

for number in [10, 20, 5, 10]:
    print(number)

for number in (10, 20, 5, 10):
    print(number)

for point in ((10, 20), (5, 2), (20, 30)):
    print(point)

# použití tuple unpackingu, velice populární a čisté řešení!
for x, y in ((10, 20), (5, 2), (20, 30)):
    print(x, y)

# zanořený unpacking
cities = [
    ('Tokyo','JP',36.933, (35.689722, 139.691667)),
    ('Delhi NCR', 'IN', 21.935, (28.613889, 77.208889)),
    ('Mexico City', 'MX', 20.142, (19.433333, -99.133333))]

for name, short_name, population, (latitude, longitude)  cities:
    (name, short_name, population, latitude, longitude)
# PEP8 - pojmenování nepoužité hodnoty
for x, _ in ((10, 20), (5, 2), (20, 30)):
    print(x)
Vytvoření dvojrozměrného seznamu.
matrix = [
    [1, -2, 5, 20],
    [0, 2, 3, 400],
    [100, 2, 3, 4],
]

# problém - vytvoření matice 2x3 vyplněné nulama
matrix_zeroes = [[0] * 3] * 2

# pozor, nastane však problém!
# operátor * vnitřní seznam nezkopíruje, jen zopakuje odkaz na tentýž seznam
matrix_zeroes[0][0] = 1
# výsledek je [[1, 0, 0], [1, 0, 0]], změnil se zdánlivě i druhý řádek

# že jde skutečně o jeden a tentýž objekt, ověříme takto
matrix_zeroes[0] is matrix_zeroes[1]  # True

# správně tedy, v budoucnu se dozvíme ještě elegantnější řešení
matrix_zeroes = []

for _ in range(2):
    matrix_zeroes.append([0] * 3)

matrix_zeroes[0][0] = 1
Iterace přes množinu.
# pozor, prvky nejsou seřazené
for number in {10, 20, 5, 10}:
    print(number)

# množinu je nutné seřadit
for number in sorted({10, 20, 5, 10}):
    print(number)
Iterace přes slovník.
points = {"point 2": {"x": 10, "y": 20}, "point 1": {"x": 5, "y": 2}}

# přes klíče a hodnoty
for label, point in points.items():
    print(label, point)

# pouze přes klíče
for label in points.keys():
    print(label)

# pouze přes hodnoty
for point in points.values():
    print(point)
Použití enumerate().
# získání indexu
for idx, number in enumerate([10, 20, 5, 10]):
    print(idx, number)

# jak enumerate funguje?
list(enumerate([10, 20, 5, 10]))
Použití zip().
names = ["Lukáš Novák", "Petr Novák"]
salaries = [30000, 20000]

for name, salary in zip(names, salaries):
    print(name, salary)

# jak zip funguje?
list(zip(names, salaries, ["Olomouc", "Přerov"]))

# pozor, při různých délkách zip tiše zkrátí výsledek na nejkratší vstup
# "Krnov" tedy ve výsledku vůbec není a chybu nedostaneme
list(zip(names, salaries, ["Olomouc", "Přerov", "Krnov"]))

# pokud stejné délky očekáváme, je lepší si je nechat ověřit (Python 3.10+)
# nestejně dlouhé vstupy pak vyvolají ValueError
list(zip(names, salaries, ["Olomouc", "Přerov", "Krnov"], strict=True))

# použití zip pro vytvoření slovníku
dict(zip(names, salaries))
Použití reversed().
# iterace přes otočený seznam
for number in reversed([10, 20, 5, 10]):
    print(number)
Použití range().
for number in range(10):
    print(number)

for number in range(5, 10):
    print(number)

# lichá čísla
for odd_number in range(1, 10, 2):
    print(odd_number)

# jak range funguje?
list(range(0, 10, 2))

for number in range(10, 0, -1):
    print(number)

for number in reversed(range(10)):
    print(number)
Cyklus while
Více informací zde.
numbers = [10, 20, 5, 10]

while numbers:
    print(numbers.pop())
while True:
    user_input = input("Input:")

    if user_input == 'stop':
        # příkaz break přeruší nadřazený cyklus, rovněž existuje continue
        break
    else:
        print(user_input)
Příkaz if v kontextu sekvencí
Více informací zde.
numbers = []

# co se zde děje?
if numbers:
    print(numbers)

# toto, není to však třeba explicitně psát
if bool(numbers):
    print(numbers)
# PEP8 - využívejte faktu, že prázdné sekvence jsou vyhodnoceny jako False
# správně
if not numbers:
    pass

if numbers:
    pass

# špatně
if not len(numbers):
    pass

if len(numbers):
    pass

# PEP8 - pořadí psaní podmínek
numbers = [1, 20, 5, 1]

# správně
if 10 not in numbers:
    print("There is no 10!")

# špatně
if not 10 in numbers:
    print("There is no 10!")